Le Data Mesh promet l’autonomie des domaines métier. Sans patrimoine commun, sans règles appliquées automatiquement et sans contrôle de ce qui est publié, cette autonomie produit l’inverse : des données fragmentées, un Data Office débordé et des Data Products qu’aucun usage IA ne peut consommer en confiance.
Gouvernance des données : des règles partout, un pouvoir introuvable
Les grandes entreprises n’ont sans doute jamais autant investi dans la gouvernance de leurs données. Data Office, propriétaires de données nommés, catalogues, glossaires, outils de qualité et de traçabilité, architectures Data Mesh, et désormais cadres de gouvernance de l’IA. Pourtant, plus l’édifice se structure, plus une question simple devient difficile à trancher : qui contrôle réellement le patrimoine de données, de bout en bout ?
Avec l’IA, cette zone grise coûte cher. Face à une donnée incomplète, un analyste comble les trous avec sa connaissance du métier. Un agent, un copilote ou un assistant qui puise dans les documents internes (RAG) propage l’approximation à la vitesse de la machine.
En février 2024, Gartner prévoyait que 80 % des initiatives de gouvernance Data & Analytics échoueraient d’ici 2027, faute d’être rattachées à une crise réelle ou provoquée qui les rende prioritaires. L’IA pourrait bien être cette crise. Encore faut-il que la gouvernance des données pour l’IA sache démontrer la confiance, et pas seulement inventorier l’existant.
Data Mesh : trois mécanismes qui fabriquent des Data Products inutilisables
Nos diagnostics convergent vers trois mécanismes qui s’enchaînent : objets patrimoniaux instables et sémantique divergente ; règles non exécutables qui recentralisent les validations ; couches Bronze/Silver/Gold réduites au stockage et Data Products qui reconstruisent localement ce que l’entreprise pensait mutualiser.
Mécanisme | Ce qui se passe | Ce que montre le terrain | Conséquence |
1. Le chaos d’urbanisation | Les domaines gagnent en autonomie sans socle de définitions partagé ni référentiel commun. | Jusqu’à 340 variantes d’une entité « Client » ; 4,2 M€ par an de flux de données dupliqués ; 18 à 23 % du budget IT concerné absorbé par des intégrations redondantes (cas anonymisé). | Chaque projet transverse tourne à la réconciliation. La donnée reste attachée aux projets au lieu de devenir un patrimoine. |
2. L’illusion de gouvernance | Des propriétaires nommés mais sans moyens, des standards sur papier, des validations manuelles. | Plus de 200 demandes en attente, 8 à 12 semaines de délai, 71 % de refus à la première soumission (programme industriel anonymisé). | Le Data Office reste responsable, mais devient le goulot d’étranglement qu’il devait supprimer. |
3. Le piège des couches | Les couches Bronze, Silver et Gold servent à ranger les données, pas à mesurer leur niveau de confiance. | Environ 15 % de réutilisation ; 60 % des actifs reconstruits localement ; jusqu’à 40 % d’incidents en plus liés aux changements cassants, aux dérives et aux engagements non tenus. | La plateforme fait circuler toujours plus de données, sans les capitaliser ni les fiabiliser. |
Source : observations terrain sur 35+ programmes analysés depuis 2022. Cas et chiffres anonymisés : ils illustrent des mécanismes récurrents et ne constituent pas des moyennes de marché.
Le symptôme le plus parlant touche le responsable des données (CDO). Il reste en poste, le Data Office existe, le catalogue est déployé. Mais la sémantique vit dans les métiers, les modèles dans les projets, les flux dans l’IT, les habilitations à la sécurité, la qualité et la traçabilité dans leurs outils respectifs. Le CDO garde la responsabilité. Peut-il pour autant bloquer la publication d’un actif non conforme, ou retrouver immédiatement la donnée de référence, ses utilisateurs et ses dérogations ? Si la réponse mobilise trois équipes et un comité, le pouvoir d’agir a quitté le centre. Sans que personne l’ait décidé.
Donner plus d’autonomie aux domaines ne règle rien tant que cette autonomie reste théorique. Deux scénarios se présentent alors. Soit le domaine dépend toujours du centre pour publier, et l’autonomie se réduit à un circuit d’approbation. Soit il contourne le centre, fixe ses propres définitions et ses propres seuils, et recrée des silos, fédérés cette fois.
Gouvernance des données pour l’IA : rendre les règles exécutables
Les grandes organisations ne manquent plus de standards. La rupture se joue sur le dernier kilomètre, celui où une règle écrite devient un comportement réellement appliqué dans la production des données.
Dans beaucoup de programmes, la règle se transforme en liste de contrôle, vérifiée à la main en fin de projet. On contrôle après avoir construit au lieu d’intégrer la règle à la conception, aux tests, à la mise en production et à l’exploitation. D’où un effet contre-intuitif : plus il y a de règles, plus il y a de revues et d’escalades. Dans le programme industriel du tableau, les standards existaient bel et bien. Ils manquaient de précision, n’étaient pas testables et restaient à l’écart du quotidien des équipes.
Sortir de cette impasse passe par trois décisions.
Écrire des règles qu’une machine peut vérifier. Seuils de qualité, droits d’accès, délais de mise à jour : tout ce qui peut être testé automatiquement doit l’être. Une règle impossible à tester finit presque toujours en réunion.
Contrôler là où la donnée est produite. Gartner recommande d’opérer la gouvernance au plus près de l’exécution et de concevoir le passage à l’échelle en limitant les escalades. La bonne mesure d’une organisation fédérée devient alors le nombre de décisions qu’un domaine peut prendre seul sans abîmer la cohérence commune, bien plus que le nombre de propriétaires nommés.
Piloter les Data Products comme un portefeuille. Un gestionnaire d’actifs data (Data Asset Manager) suit la réutilisation, la cohérence des définitions, l’adoption, la dette et le retrait des actifs. Le Data Office fixe le cadre ; les domaines portent le sens et la valeur.
Données AI-ready : notre conviction, la prochaine frontière est le droit de publier
Chez JEMS, notre position est nette. La gouvernance de demain se jugera moins au nombre d’objets catalogués qu’à sa capacité à décider ce qui entre dans le patrimoine, y évolue et y reste. Le Data Office n’a pas vocation à approuver chaque projet : il fixe les conditions de confiance et arbitre les exceptions.
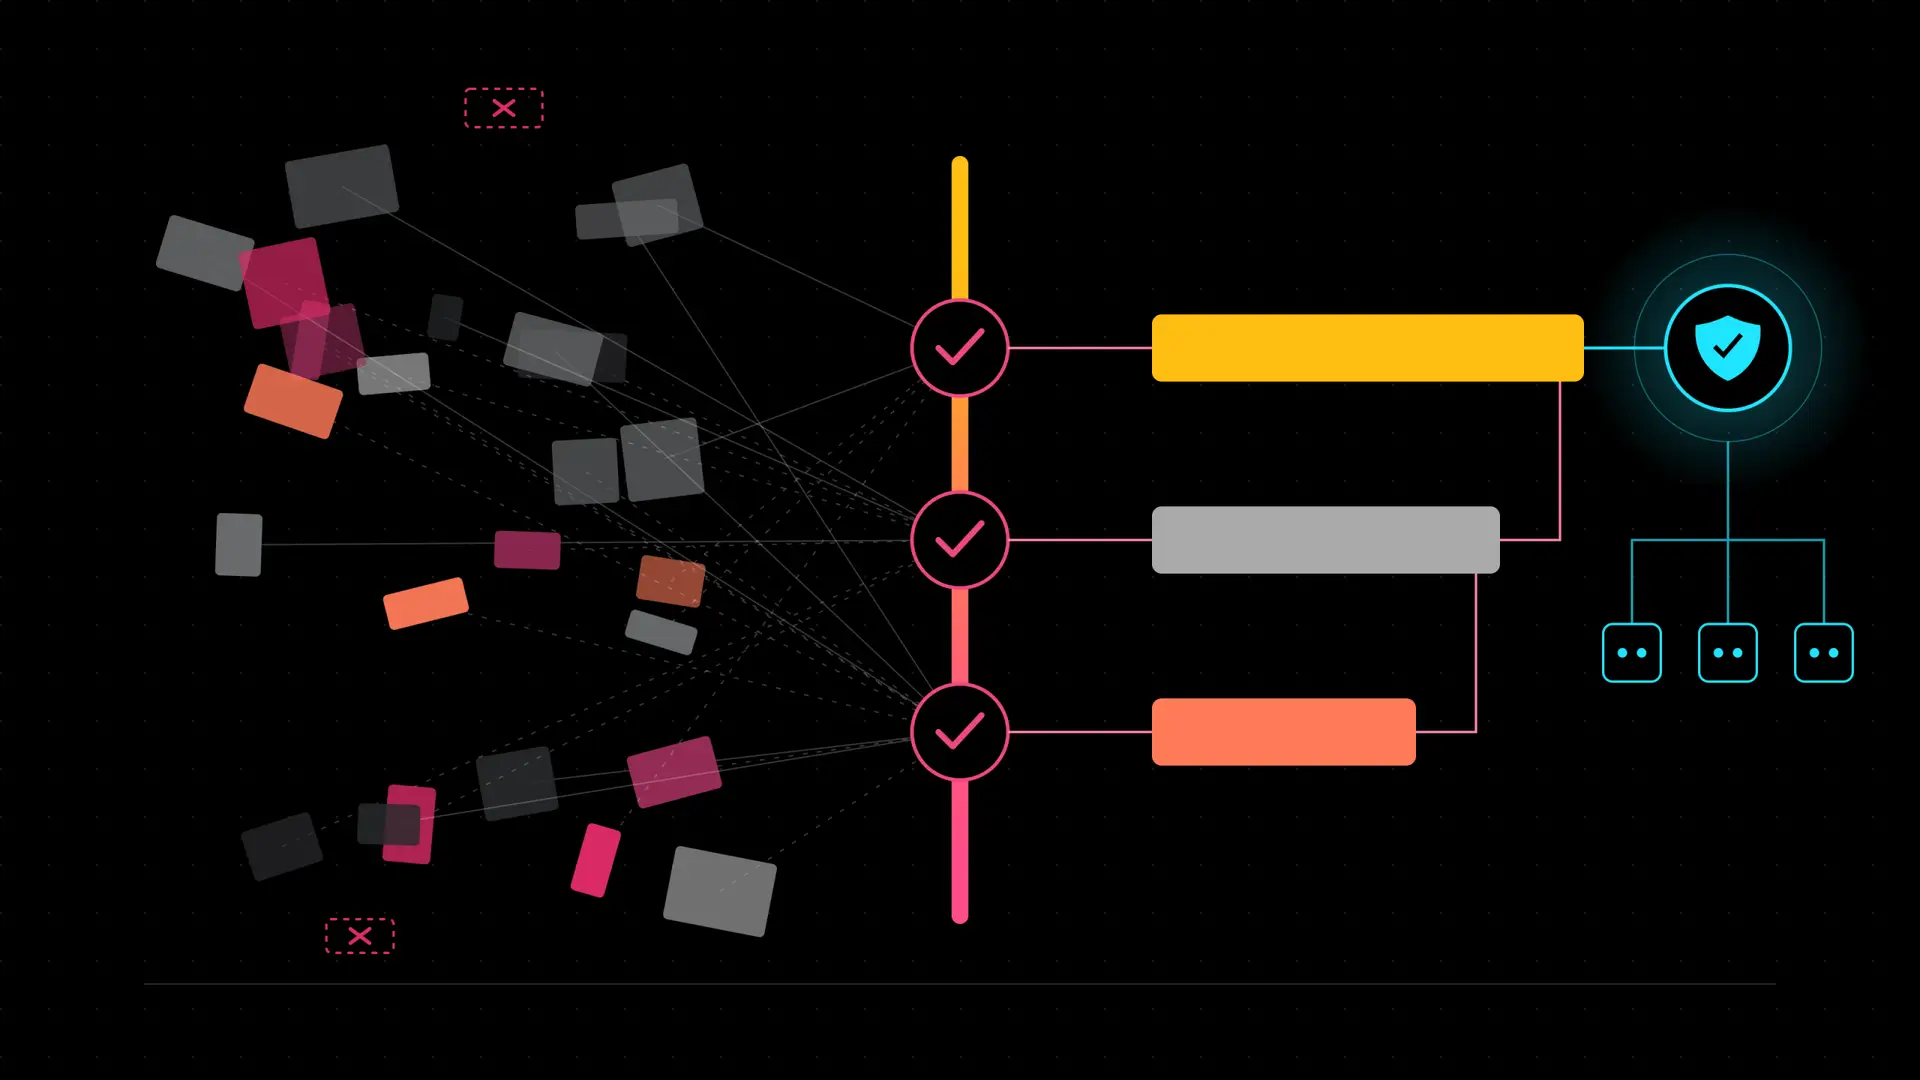
La question posée change donc. Savoir si un produit figure au catalogue ne suffit plus ; il faut savoir quelles preuves autorisent sa publication et sa réutilisation par d’autres domaines. Accorder le droit de publier revient à vérifier quelques conditions explicites :
- Sens : des définitions claires et partagées entre domaines
- Qualité : une fiabilité mesurée plutôt que déclarée
- Sécurité : des accès et une conformité maîtrisés
- Traçabilité : l’origine et le parcours de la donnée, de bout en bout
- Engagements de service : des niveaux de disponibilité et de fraîcheur tenus dans le temps
- Surveillance : un suivi continu après publication
L’IA rend ces conditions incontournables. Selon Gartner (février 2025), 63 % des organisations n’ont pas, ou ne savent pas si elles ont, les pratiques de gestion des données adaptées à l’IA, et 60 % des projets IA privés de données AI-ready seront abandonnés d’ici fin 2026. Gartner anticipe aussi qu’en 2028 la moitié des organisations adopteront une posture de « confiance zéro » envers leurs données, face à l’afflux de contenus générés par l’IA et non vérifiés (janvier 2026).
Pour nous, une donnée AI-ready relève donc du même effort : c’est le niveau de maturité où le sens, la provenance et les conditions d’usage d’un Data Product sont assez explicites pour qu’un agent sache s’il a le droit de s’en servir.
Où en est votre chaîne de confiance data ? → Échanger avec un expert
Donner enfin une couche d’exécution à la gouvernance
Le Data Mesh ne manque pas de bonnes intentions. Il bute sur des responsabilités distribuées sans moyens, des standards restés sur papier et des publications qui ne dépendent d’aucun niveau de confiance mesurable. L’étape suivante ne consiste ni à ajouter de la gouvernance, ni à décentraliser davantage, mais à relier, dans la chaîne de production de chaque Data Product, les définitions, les engagements, les contrôles et les preuves. Le Data Office retrouve alors un pouvoir réel, sans redevenir un guichet.
Vos Data Products sont-ils des actifs certifiés ou des livrables déguisés ? La réponse se mesure, programme par programme. Les experts JEMS vous proposent de confronter votre modèle de gouvernance à ces trois mécanismes et d’identifier ce qui vous sépare d’un patrimoine réellement AI-ready.
Passez votre gouvernance au crible :
Échangez avec les experts JEMS